原来的处理路径
阅读客户问题 → 翻查资料/SOP → 对照历史案例 → 组织回复 → 核实后发送。
知识库检索与回复草稿,保留人工审核
PROBLEM → INITIATIVE → WORKFLOW
这是一个从实习现场的问题出发的AI应用实践:我主动发现查找售后资料的困难,先处理知识,再把检索、生成和人工审核接到实际工单流程中。
售后问题需要同时理解客户的诉求、查找适用SOP,并参考历史处理方式。资料查找不方便,会让客服在阅读工单和翻查文档之间反复切换。我希望把“找资料”和“组织草稿”接起来,让客服把精力放在核实与判断上。
阅读客户问题 → 翻查资料/SOP → 对照历史案例 → 组织回复 → 核实后发送。
客户问题 → 相关知识检索 → 分析与草稿进入内部备注 → 客服核实、修改并发送。
实习中,我发现跨境公司的售后处理很繁琐。资料、SOP和历史案例分散,遇到具体问题时查找不方便;即使找到了资料,还需要把规则转换成适合客户的回复。
我先整理售后资料、SOP和历史案例,再做数据清洗,为后续检索准备输入。这个步骤把零散材料组织成可使用的知识,避免直接把杂乱原文交给模型。
用阿里云嵌入模型把内容转换为向量,为语义检索建立基础。向量化负责表达文本的语义,不负责决定售后政策,也不是重新训练一个客服大模型。
将知识用于Dify向量检索,围绕客户问题匹配相关内容,把检索结果作为回复生成的依据。检索阶段回答的是“哪些资料可能与这次问题有关”。
由DeepSeek理解客户问题、判断意图,并结合检索到的知识生成回复草稿。客户诉求、缺失信息、建议处理步骤与待审核回复需要让客服能快速辨认。
用n8n衔接流程,把AI分析和草稿写入Zendesk内部备注。结果进入客服已有的工单界面,客服无需再去另一个工具复制草稿。
客服检查事实、订单与政策适用条件,修改草稿后正式回复客户。内部备注是辅助处理的中间结果,不能当作已经发给客户的答案。
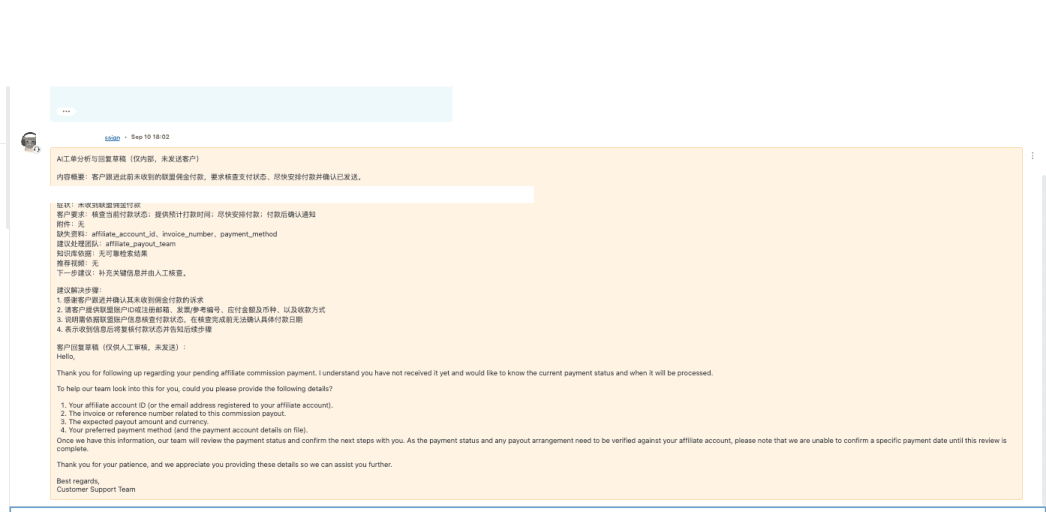
根据本人提供的Zendesk运行截图整理。上方展示隐去工单编号和人员标识的运行截图,下方整理其处理逻辑。该示例说明内部备注已经包含分析、缺失信息和英文草稿,不证明所有工单均已覆盖。
这个案例的价值也在于暴露下一步该改什么:当检索没有可靠结果时,系统应明确表达不确定性,帮助客服追问和核实,避免把语言流畅误当成事实充分。
发现实习中的售后检索困难;整理和清洗售后资料;串联向量化、Dify知识检索、DeepSeek生成与n8n写入Zendesk的流程。
本人提供的实际内部备注截图,包含工单摘要、意图、资料缺口、处理建议与英文回复草稿。客服保留正式回复的审核环节。
以下为后续优化方案,区别于上面的已运行流程。
按问题类型、产品、地区和政策有效期组织材料,记录来源、更新人和适用条件;去重、统一术语,并检查新旧SOP冲突。
用脱敏历史问题建立评估集,分别检查是否找对知识、是否漏掉关键限制;再调整切分、召回数量、过滤与重排策略。
对无命中、资料冲突、金额和政策承诺等情况明确标记待核实;先输出追问清单,避免生成无法核实的承诺。
增加去重、重试和写入后读回检查,区分模型生成失败与Zendesk写入失败,避免重复内部备注或漏写。
记录草稿被采用、修改或放弃的原因,把重复出现的缺口转成知识库维护任务,再检查修改后的效果。
后续采集有效检索率、草稿采用率、实质修改原因与查找耗时;先定义口径和基线,再比较效果,不预设准确率或节省比例。